Qué equipo necesitas para trabajar con IA (y cuándo no necesitas cambiarlo)
Guía de criterios para elegir portátil y puesto de trabajo si usas IA: cuánta memoria pide cada tamaño de modelo, qué cambia entre memoria unificada y VRAM dedicada, y en qué casos tu equipo actual ya te sirve.
Casi todas las guías de «equipo para IA» empiezan recomendándote un portátil. Esta empieza al revés: es muy probable que no necesites comprar nada.
Si tu trabajo con inteligencia artificial consiste en usar ChatGPT o Claude en el navegador, redactar con una extensión, montar automatizaciones en Make o dejar que Notion te resuma reuniones, todo eso ocurre en servidores que no son tuyos. Tu ordenador solo dibuja una página web. Un portátil de hace cinco años hace eso igual de bien que uno recién comprado, y cambiarlo no te va a dar ni una respuesta mejor ni una más rápida.
Esta guía existe para el caso contrario: cuando sí hay un motivo técnico para que el equipo importe. Y para que, si acabas comprando, sepas qué especificación mirar y cuál es marketing.
Una aclaración antes de seguir, porque afecta a cómo debes leer lo que viene: en AutomatizayEscala no probamos hardware. No tenemos un laboratorio ni hemos medido estos equipos. Lo que encontrarás aquí son criterios derivados de cómo funcionan los modelos, no un ranking de productos. Los enlaces de compra van a búsquedas filtradas por esos criterios, no a un modelo concreto que te estemos recomendando.
Cuándo tu equipo actual ya vale
Estos usos no piden nada especial. Si es lo que haces, ahórrate el dinero:
- Chat en el navegador. ChatGPT, Claude, Gemini, Copilot. El modelo corre en la nube.
- Automatizaciones. Make, n8n en servidor, Zapier. Se ejecutan en su infraestructura, no en tu mesa.
- Asistentes dentro de aplicaciones. Notion AI, el asistente de tu CRM, transcripción de reuniones en la nube.
- Generar imágenes o vídeo con servicios de pago. Midjourney, Runway, HeyGen. Mismo caso.
En todos ellos el cuello de botella es tu conexión y el plan que tengas contratado, no tu procesador. Si notas lentitud, mira ahí antes que en la tienda.
Cuándo sí cambia la cosa
Hay tres situaciones en las que el equipo pasa a ser el límite real:
Ejecutar modelos en local. Descargarte un modelo y correrlo en tu máquina, sin enviar nada fuera. El motivo habitual en una pyme no es la velocidad: es que hay datos que no quieres que salgan de la oficina —expedientes, nóminas, historiales— y con un modelo local no salen. También desaparece el coste por uso y funciona sin conexión.
Generar imagen o vídeo en local. Los modelos de difusión son exigentes con la memoria de la tarjeta gráfica, más aún que los de texto.
Sesiones largas y pesadas. Veinte pestañas, un editor, varias videollamadas al día y un modelo de transcripción corriendo de fondo. Aquí no manda la IA: manda la RAM del sistema.
Si no estás en ninguno de los tres, el resto de esta guía es informativo y puedes cerrarla tranquilo.
La cuenta que de verdad decide: memoria
Para ejecutar un modelo en local, lo primero es que quepa en memoria. Todo lo demás viene después. La aritmética es sencilla y conviene saberla porque te ahorra caer en la especificación equivocada:
Un modelo se mide en parámetros (7B = siete mil millones). Cada parámetro ocupa un espacio que depende de la cuantización: a 4 bits, medio byte por parámetro. Así que un modelo de 7B cuantizado a 4 bits ocupa unos 3,5 GB, más un margen para el contexto y el propio programa.
De ahí sale una regla práctica para orientarte:
| Memoria disponible para el modelo | Tamaño que puedes mover con holgura (4 bits) |
|---|---|
| 8 GB | modelos de ~7B |
| 16 GB | modelos de ~13B |
| 32 GB | modelos de ~30B |
| 64 GB o más | los grandes, y varios a la vez |
Son órdenes de magnitud, no garantías: el consumo real sube con el tamaño del contexto y varía según el programa que uses. Pero sirve para lo importante, que es no comprar 8 GB pensando que vas a mover un modelo de 30B.
Memoria unificada y VRAM no son lo mismo
Aquí es donde más gente se equivoca al comparar presupuestos, así que merece la pena pararse.
En un Mac con Apple Silicon la memoria es unificada: el procesador y la parte gráfica usan el mismo bloque. Si el equipo tiene 24 GB, buena parte de esos 24 GB están disponibles para el modelo. Por eso un Mac con bastante memoria mueve modelos que en un PC exigirían una tarjeta gráfica cara.
En un PC con tarjeta dedicada lo que cuenta para el modelo es la VRAM de la gráfica, no la RAM del sistema. Un portátil con 64 GB de RAM y una gráfica de 8 GB mueve, a efectos del modelo, 8 GB. Si el modelo no cabe en la VRAM, parte se va a la RAM del sistema y el rendimiento se desploma.
La consecuencia práctica: al comparar equipos para IA local, compara memoria útil para el modelo, no la cifra grande del anuncio. En Mac mira la memoria unificada; en PC, la VRAM de la gráfica.
Lo que se vende mucho y decide poco
- El número de núcleos del procesador. Generar texto con un modelo depende sobre todo del ancho de banda de memoria. Un procesador con muchos núcleos no compensa quedarse corto de memoria.
- El sello «IA» del portátil. Los aceleradores que llevan los portátiles recientes están pensados para tareas ligeras del sistema —desenfocar el fondo en una videollamada, dictado— y hoy la mayoría de programas de modelos locales ni los usan. No lo tomes como prueba de que el equipo mueve modelos.
- La pantalla táctil, el lector de huella, el color del chasis. Están bien, pero no cambian nada de lo anterior.
Criterios de compra, traducidos a búsqueda
Si después de todo lo anterior toca comprar, estos son los criterios. Los enlaces abren una búsqueda en Amazon filtrada por especificación: no son modelos que hayamos probado ni recomendado, son la forma de ver qué hay hoy que cumpla el criterio.
Si vas a ejecutar modelos de texto en local, de forma ocasional Busca 16 GB de memoria como suelo. Es el punto en que dejas de pelearte con el tamaño y puedes mover modelos de ~13B. → Portátiles con 16 GB de RAM · Mac con 16 GB de memoria unificada
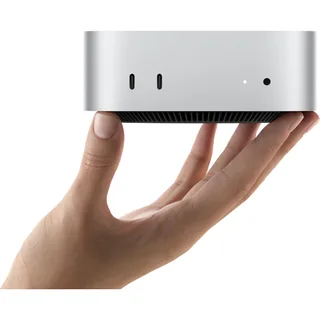
Apple Mac mini con chip M4 (16 GB de memoria unificada)
Sobremesa: la vía más barata de tener memoria unificada. Al ser unificada, buena parte de esos 16 GB quedan disponibles para el modelo.
Precio y disponibilidad
en Amazon
Si va a ser tu herramienta de trabajo diaria 32 GB cambia bastante: modelos de ~30B, varias cosas abiertas y margen para años. → Portátiles con 32 GB de RAM · Mac con 24 GB o más de memoria unificada
HP 15-fc0240ns — 15,6 pulgadas FHD, Ryzen 7-7730U, 32 GB RAM, 1 TB SSD
Gráfica integrada: sirve para modelos de texto sobre CPU y para trabajar con muchas cosas abiertas, no para generar imagen.
Precio y disponibilidad
en Amazon
Lenovo IdeaPad Slim 5 Gen 10 — 16 pulgadas WUXGA, Core Ultra 9 185H, 32 GB RAM
Mismo caso que el anterior, con pantalla de 16 pulgadas y procesador más reciente.
Precio y disponibilidad
en Amazon
Si vas a generar imagen o vídeo en local Aquí lo que manda es la VRAM de la gráfica. Por debajo de 12 GB te vas a chocar con los modelos de difusión actuales. → Portátiles con gráfica dedicada de 12 GB o más
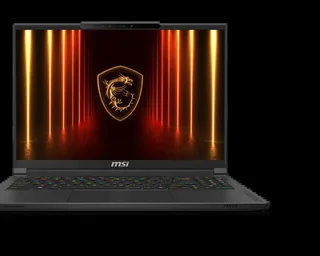
MSI Stealth A16 AI+ — Ryzen 9 HX 370, 32 GB RAM, 1 TB SSD, RTX 5080
La RTX 5080 para portátil lleva 16 GB de VRAM: por encima del umbral de 12 GB donde los modelos de imagen dejan de ir justos.
Precio y disponibilidad
en Amazon
Almacenamiento Los modelos ocupan. Varios de tamaño medio se comen un disco de 512 GB sin esfuerzo, y conviene no llenarlo del todo. → SSD NVMe de 2 TB
El resto del puesto No tiene que ver con la IA, pero si vas a pasar el día delante, es donde más se nota el dinero. → Monitores de 27 pulgadas · Bases de conexión USB-C
Antes de pagar, dos comprobaciones
Prueba el modelo antes de comprar el equipo. Programas como Ollama o LM Studio son gratuitos y te dicen en una tarde si lo que quieres hacer se sostiene, y con qué tamaño de modelo. Es información que ninguna guía —esta incluida— puede darte con tu caso concreto.
Calcula el punto de equilibrio. Un plan de pago de un modelo en la nube cuesta al mes una fracción de lo que cuesta un equipo. Si tu motivo para ir a local es el ahorro y no la privacidad, echa la cuenta: a veces salen años. Si el motivo es que los datos no salgan, entonces el equipo no es un gasto de eficiencia, es un requisito, y se decide de otra manera.
Esta página contiene enlaces de afiliado de Amazon: si compras a través de ellos, AutomatizayEscala recibe una comisión sin coste adicional para ti. Como Asociado de Amazon, obtenemos ingresos por las compras adscritas que cumplen los requisitos aplicables. No probamos el hardware que enlazamos y los enlaces son búsquedas por criterio, no recomendaciones de producto concreto. Puedes leer nuestra divulgación de afiliados completa.
Sobre el autor
Iván Jiménez MorenoEspecialista en automatización · Fundador de AutomatizayEscala.com
Analiza herramientas de automatización, IA y productividad para emprendedores y PYMEs hispanohablantes. Más de 180 herramientas evaluadas con metodología propia en 5 dimensiones.
